RAG privé sur votre propre machine avec turbovec
Chercher dans 177K fragments du journal officiel espagnol en local — sans cloud, sans clés d’API
- rag
- turbovec
- embeddings
- ollama
- boe
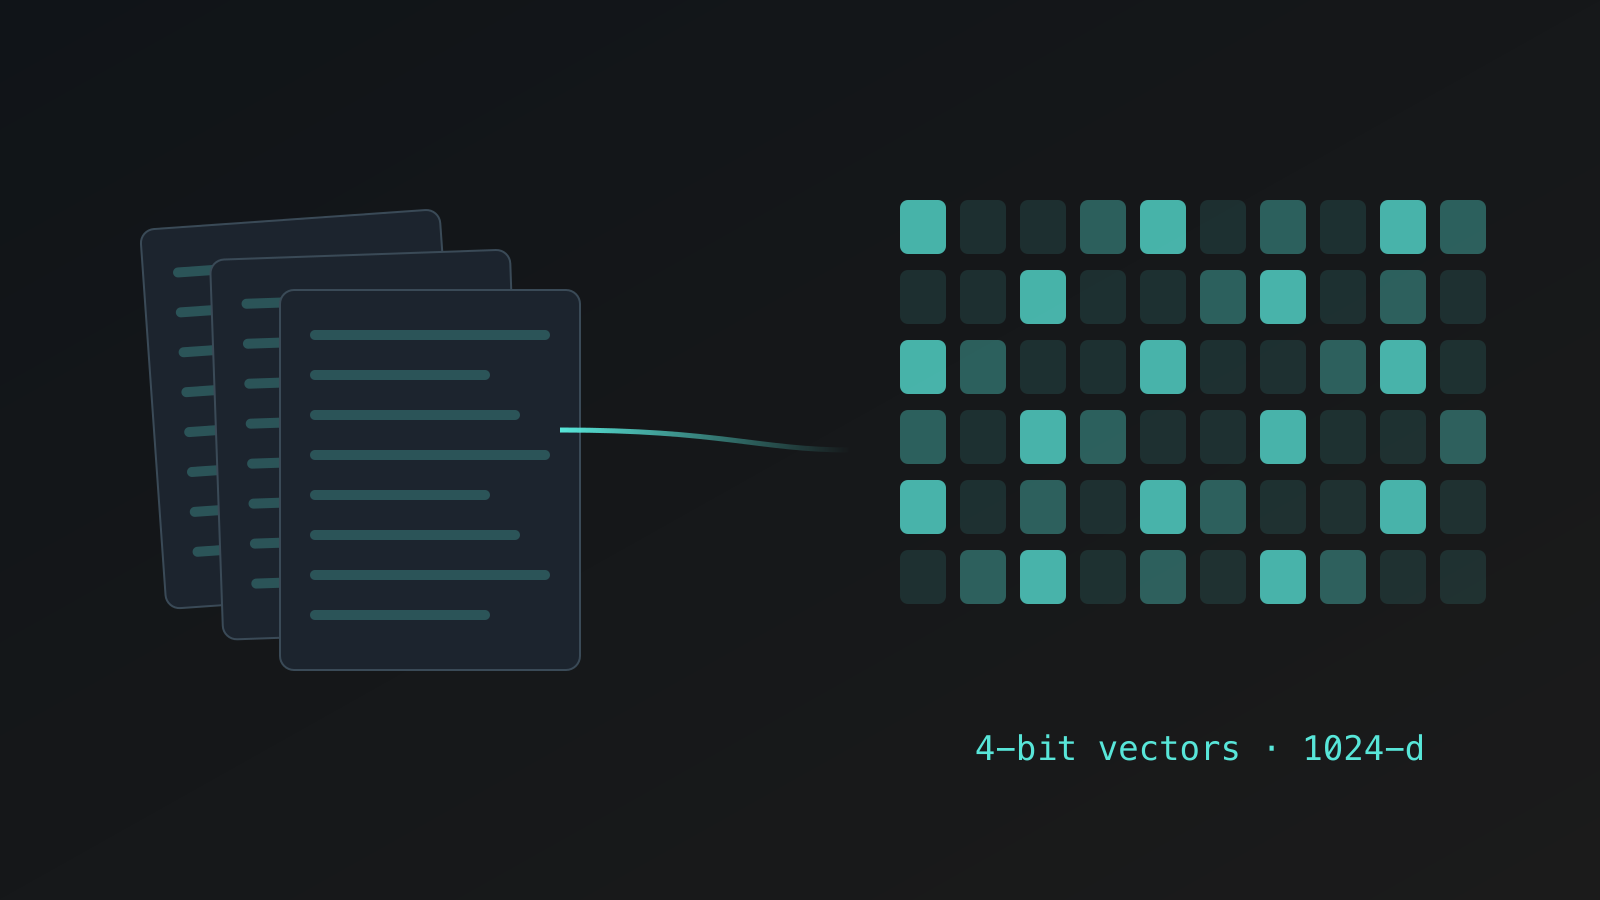
Les démos « discutez avec vos documents » finissent généralement par une base vectorielle hébergée et une clé d’API. Pas celle-ci : le modèle d’embeddings, l’index et le modèle de langue tournent tous sur votre propre machine. Comme corpus de test, j’ai utilisé quelque chose de réel et de coriace — 2 000 documents du BOE, le Bulletin officiel de l’État espagnol, convertis en Markdown. La pièce intéressante est l’index, turbovec, qui compresse les vecteurs à 4 bits par dimension et reste plus rapide que FAISS.
Pourquoi turbovec
- Sans phase d’entraînement. La plupart des index compressés (comme ceux de FAISS) doivent d’abord apprendre de vos données. TurboQuant dérive sa compression analytiquement : les vecteurs sont interrogeables dès qu’ils sont ajoutés.
- Minuscule. Tout le corpus ci-dessous — 177K passages — tient dans un index de 94 Mo. Les mêmes vecteurs non compressés occuperaient 727 Mo.
- Recherche bornée. On peut restreindre une requête à un dossier ou un projet à l’intérieur de l’index, donc les permissions n’ont pas besoin d’un index séparé.
- Vraiment hors ligne. Pas de service ni de télémétrie. Avec un modèle d’embeddings local, rien ne quitte le portable.
La pile
| Couche | Choix | Pourquoi |
|---|---|---|
| Documents | Corpus du BOE → Markdown | 2 000 lois et normes ; l’espagnol juridique dense est un vrai test de stress |
| Fragments | Passages de ~800 tokens | Assez de contexte sans perdre la pertinence |
| Vecteurs | Qwen3-Embedding-0.6B via Ollama | Petit, multilingue, tourne sur CPU |
| Index | turbovec, 4 bits | Voir ci-dessus |
| Réponses | Gemma 4 12B ou Qwen3.8-27B via Ollama | Les deux modèles de l’expérience précédente |
Comment c’est monté
La colle tient en une centaine de lignes de Python et le flux fait trois étapes :
Étape 1 — Indexer une fois. Découper chaque Markdown en passages de ~800 tokens, les vectoriser et les ajouter à un index 4 bits. Le sync rend l’écriture incrémentale et tolérante aux pannes — l’ingestion des 177K fragments a pris quelques heures et a pu reprendre après des interruptions.
index = turbovec.IdMapIndex(dim=1024, bit_width=4)
index.add_with_ids(vectors, chunk_ids)   # vectors sortent du modèle d'embeddings
index.sync("boe.tvec")                   # incrémental, à l'épreuve des pannes
Étape 2 — Chercher. Vectoriser la question et récupérer les six passages les plus proches.
scores, ids = index.search(question_vector, k=6)Étape 3 — Répondre avec des citations. Le modèle de chat ne voit que les passages récupérés et a pour consigne de les citer. C’est la partie qui le maintient honnête.
answer = chat(f"Réponds en utilisant seulement ces passages, en citant [n]:\n{passages}\n\nQ: {question}")Mesuré sur ce corpus
| Valeur | |
|---|---|
| Corpus | 2 000 documents du BOE · 445 Mo de Markdown |
| Fragments indexés | 177 580 vecteurs (1024 dimensions) |
| Index sur disque | 94,2 Mo en 4 bits — ~7,7× plus petit que les 727 Mo en float32 |
| Chargement de l’index | 0,08 s |
| Recherche médiane, k = 6 | 1,35 ms en requêtes synthétiques · ~27 ms de bout en bout dans la batterie réelle (vectorisation de la question incluse) |
| Temps de réponse complète | médiane ~18 s avec Gemma 4 12B sur le Mac de 16 Go |
J’ai ensuite passé une batterie de 11 vraies questions juridiques — durée des baux, obligations de protection des données, points du permis — dans tout le pipeline. Toutes les réponses sont revenues avec des citations vers de vraies entrées du BOE, et la recherche fut anecdotique : ~25 ms pour trouver les passages contre des secondes pour que le modèle rédige. Mon résultat préféré est le test négatif : à « que dit la législation espagnole sur la colonisation de Mars ? », le système a répondu simplement que les passages ne le couvrent pas — au lieu d’inventer un article. Ce refus est exactement ce qu’on attend d’un pipeline de recherche.
Pour situer les chiffres : chercher dans un demi-million de mots d’espagnol juridique prend à peu près le temps de rendre une seule image de jeu vidéo. La recherche a cessé d’être le goulot d’étranglement il y a longtemps — les secondes partent dans le LLM qui lit les passages, ce qui est justement la raison de l’associer à un modèle local rapide.
Ce que j’en retiens
- Le texte juridique est un excellent benchmark de RAG. Dense, formulaire, plein de renvois croisés : si la recherche fonctionne ici, elle fonctionnera sur des corpus plus faciles.
- La partie difficile n’est jamais l’index. Bien découper et écrire un prompt qui oblige à citer comptent bien plus que la base de données choisie.
- Les citations sont la fonctionnalité. Obliger le modèle à citer des passages
[n]rend les hallucinations visibles au lieu d’invisibles — et permet de sauter à la loi réelle.
Expériences liées
Génération locale d’images et de vidéo avec FLUX et Wan2.1
Des prompts DALL·E de 2023 à un pipeline entièrement hors ligne sur une RTX 3090
LLM en local : ce qui tient dans 16 Go face à 32 Go+
Gemma 4 12B sur un portable contre Qwen3.8-27B sur une RTX 3090 — mesuré, pas supposé