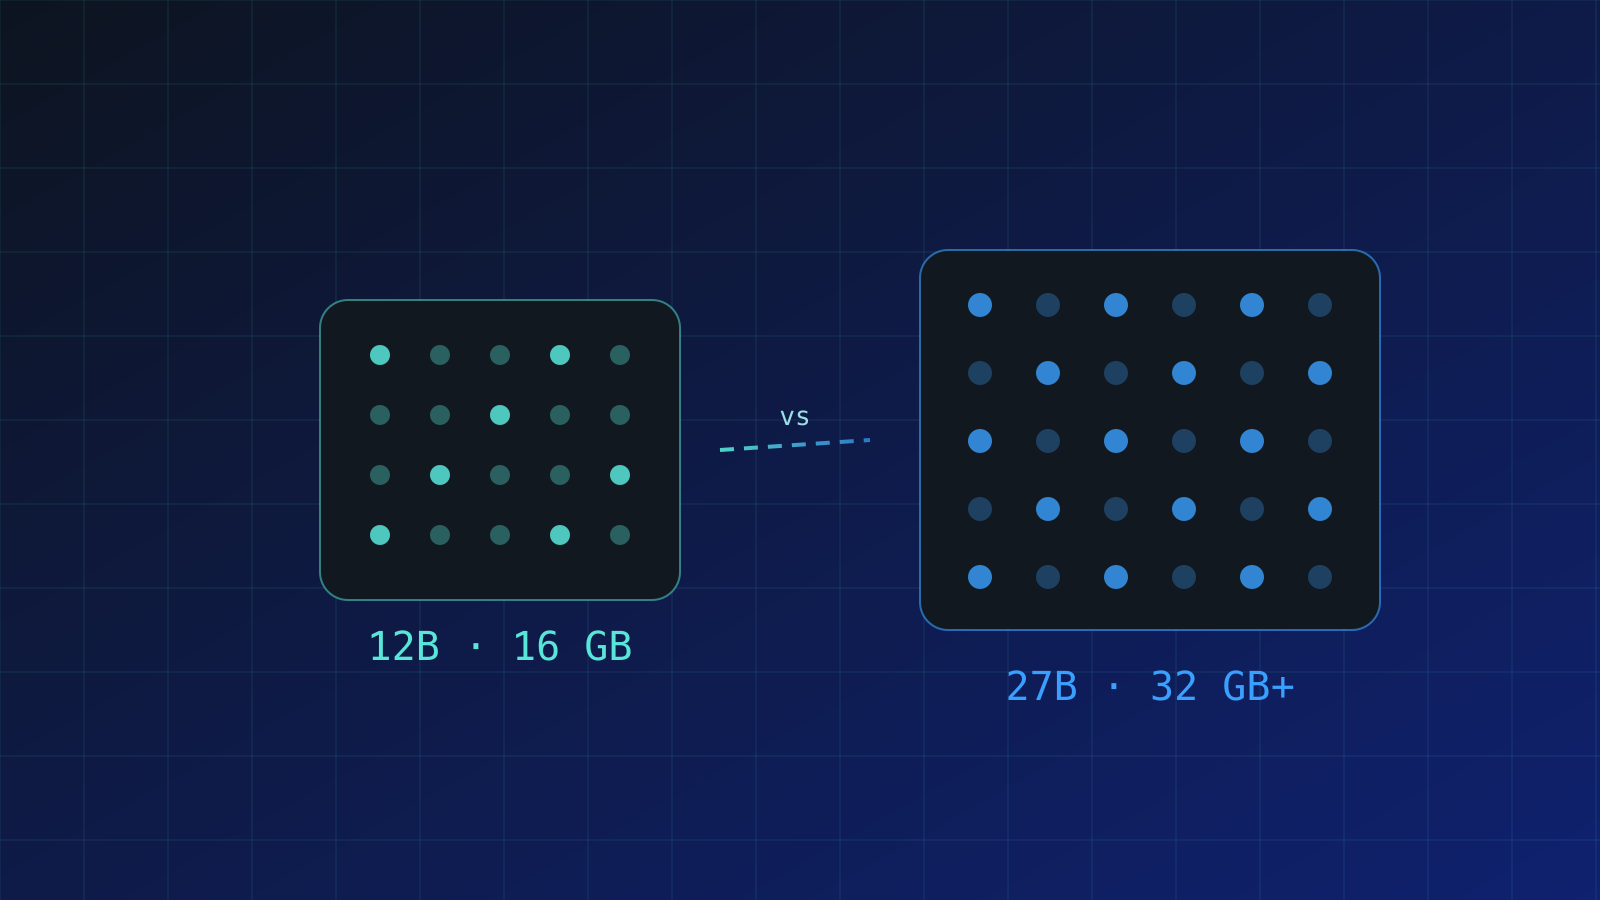
LLM en local : ce qui tient dans 16 Go face à 32 Go+
Gemma 4 12B sur un portable contre Qwen3.8-27B sur une RTX 3090 — mesuré, pas supposé
- gemma-4
- qwen3.8
- lm-studio
- apple-silicon
- rtx-3090
La réponse par défaut à « je veux essayer un document » est de le coller dans un chat dans le cloud. La mienne est différente : je fais tourner des modèles ouverts sur mes propres machines. Deux d’entre eux font presque tout le travail — Gemma 4 12B, qui tient dans un portable de 16 Go, et Qwen3.8-27B, qui demande un GPU de 24 Go. Tous deux résument des documents, écrivent en espagnol et en anglais, et codent assez bien pour que j’aie arrêté d’utiliser des API. La question que je voulais trancher avec des chiffres, pas avec des impressions : qu’est-ce que le grand modèle achète vraiment ?
Les deux modèles
| Gemma 4 12B | Qwen3.8-27B | |
|---|---|---|
| Auteur | Google DeepMind | Alibaba |
| Taille | 12B paramètres · téléchargement de 7,6 Go | 27B · 18 Go |
| Comprend | Texte, images, audio | Texte, images, vidéo |
| Mémoire | Contexte de 256K tokens | 256K, extensible à 1M |
| Licence | Gemma Terms of Use | Apache-2.0 (totalement ouverte) |
| Tourne sur | Portable de 16 Go | RTX 3090 ou Mac de 32 Go+ |
| Plus d’info | Fiche du modèle · ollama gemma4 |
Blog de Qwen · ollama qwen3.8 |
En résumé : Gemma est le modèle qu’on emporte ; Qwen, celui qu’on va voir. Une machine de 16 Go plafonne autour de 12B paramètres en bonne qualité — au-delà, les poids ne rentrent tout simplement plus. Une carte de 24 Go, c’est là que commence le niveau « sérieux ».
Le test
Neuf tâches, trois exécutions chacune, les mêmes prompts des deux côtés :
- Lire un document — un article technique d’une vingtaine de pages : rédiger un résumé exécutif, extraire des données structurées en JSON et répondre à des questions en citant les passages exacts d’où vient la réponse.
- Écrire et traduire — un post de 600 mots en espagnol à partir d’un brief en anglais, un fil de Slack transformé en rapport formel pour la direction, et une traduction où dix termes du glossaire devaient être respectés.
- Programmer — écrire une fonction Python avec des tests qui doivent vraiment passer, refactoriser un module TypeScript sans le casser, et diagnostiquer un stack trace.
Tout est mesuré (tokens par seconde, temps total) et chaque affirmation est vérifiée automatiquement quand c’est possible : le JSON doit être valide, les tests doivent passer, les termes du glossaire doivent apparaître. Le runner est un petit script Python qui fonctionne contre Ollama ou LM Studio, donc les chiffres sont reproductibles sur votre propre machine.
Résultats
| Tâche | Gemma 4 12B (QAT)Mac · Apple Silicon 16 GB | Qwen3.8-27BPC · NVIDIA RTX 3090 24 GB |
|---|---|---|
| Python function + pytest | 8.7 tok/s✓ | 16.9 tok/s✓ |
| TypeScript refactor (behaviour preserved) | 9 tok/s✓ | 14.8 tok/s✓ |
| Explain a stack trace and propose a fix | 9 tok/s | 15.3 tok/s |
| Technical post ES from EN brief | 9.1 tok/s✗ | 18.7 tok/s✓ |
| Informal thread → formal status update | 9.2 tok/s | 14.5 tok/s |
| EN→ES translation with glossary | 8.9 tok/s✓ | 18.3 tok/s✓ |
| Executive summary (200 words) | 10.8 tok/s | 16.9 tok/s |
| Structured extraction to JSON | 8.5 tok/s✓ | 18.3 tok/s✗ |
| Grounded Q&A with citations | 8.9 tok/s | 17.6 tok/s |
Ce qui m’a surpris
- La vitesse n’est pas équitable — et pas dans le sens que j’attendais. Le modèle de 27B sur la 3090 génère à 15–19 tok/s ; le 12B sur le portable, à 8,5–11. Deux fois plus gros, presque deux fois plus rapide : la bande passante mémoire du GPU bat la pénalité de taille. Le temps total raconte la même histoire : Qwen a réécrit un fil Slack en 30 s là où Gemma a mis 95 s.
- En code, match nul. Tous deux ont écrit une fonction correcte avec une suite de tests passée du premier coup (8 et 7 tests), et tous deux ont refactorisé le module TypeScript proprement au regard de
tsc --strict. Les 15B paramètres supplémentaires ont acheté de la vitesse, pas de la justesse. - En lecture de documents, le meilleur et le pire moment. Tous deux ont répondu avec des citations réelles du texte, sans références inventées. Mais Qwen a brûlé ~5 900 tokens sur la tâche JSON et a renvoyé une sortie vide sur les trois exécutions : sa réponse est partie dans le canal de raisonnement caché au lieu de la réponse. Une bizarrerie du serveur, pas un défaut du modèle — et une leçon utile si vous servez des modèles « thinking » derrière des endpoints compatibles OpenAI.
- Instructions : le grand modèle est plus strict. Tous deux ont respecté le glossaire de la traduction. Mais sur le post en espagnol, Qwen a suivi toutes les contraintes de format tandis que Gemma — propre, bon contenu — a remplacé sans permission la liste à puces demandée par des titres numérotés. Petite erreur, mais du genre à casser des pipelines.
Verdict. Si votre machine a 16 Go, Gemma 4 12B est vraiment capable : rien dans cette batterie ne lui a posé problème, et il consomme peu de mémoire. Si vous pouvez donner 24 Go à la tâche, Qwen3.8-27B est le meilleur compagnon quotidien : environ le double de débit et au moins aussi obéissant. Je garde les deux.
Expériences liées
Génération locale d’images et de vidéo avec FLUX et Wan2.1
Des prompts DALL·E de 2023 à un pipeline entièrement hors ligne sur une RTX 3090
RAG privé sur votre propre machine avec turbovec
Chercher dans 177K fragments du journal officiel espagnol en local — sans cloud, sans clés d’API