Generación de imagen y vídeo en local con FLUX y Wan2.1
De los prompts en DALL·E de 2023 a un pipeline totalmente offline en una RTX 3090
- flux
- wan2.1
- comfyui
- difusión
- rtx-3090
El clip que encabeza esta página nunca pasó por un servicio en la nube. El fotograma se generó con FLUX y después se animó con Wan2.1 image-to-video, ambos ejecutándose en ComfyUI sobre una única NVIDIA RTX 3090 (24 GB). Hace tres años la misma idea consistía en escribir prompts en DALL·E y esperar a que un servidor en otro lugar respondiera. Esta página cuenta ese cambio y ofrece un mapa práctico de lo que hoy se puede ejecutar en hardware de consumo.
Dónde empezó: DALL·E, 2023
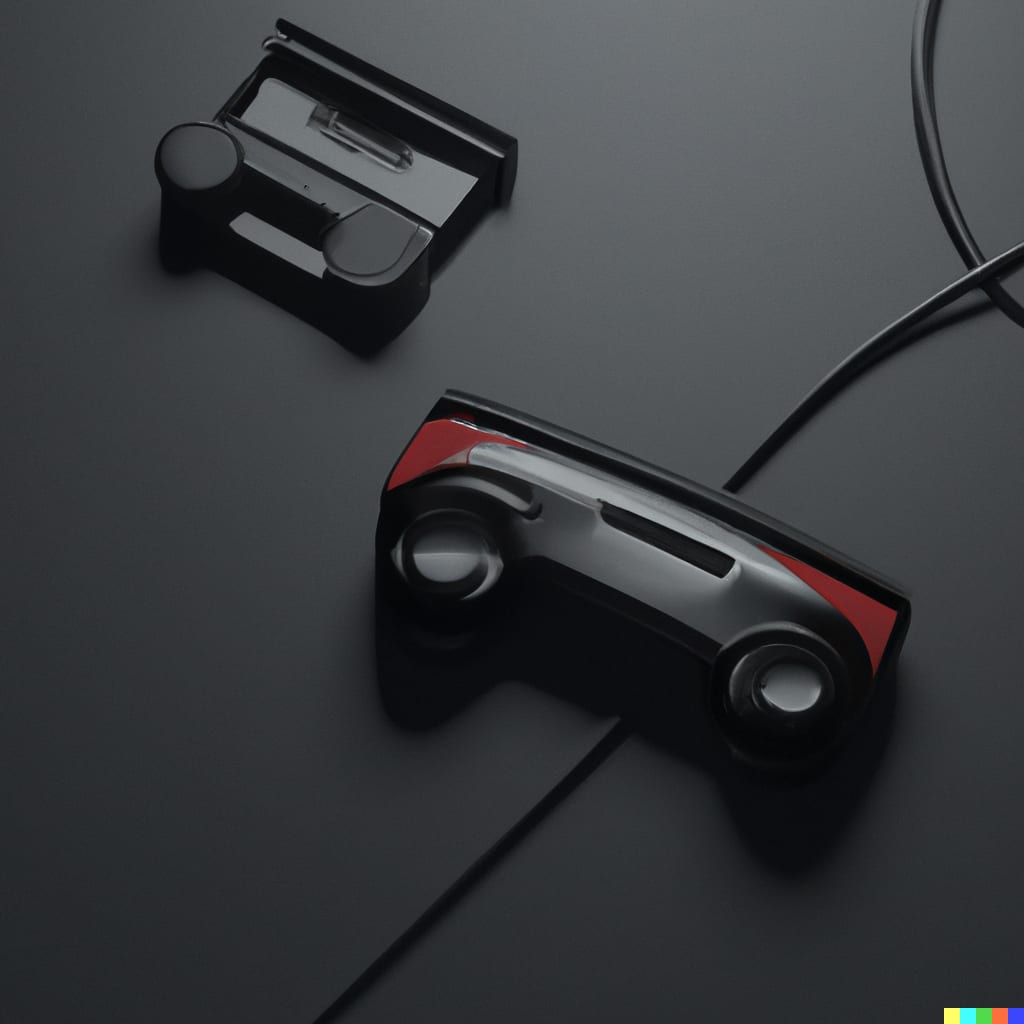
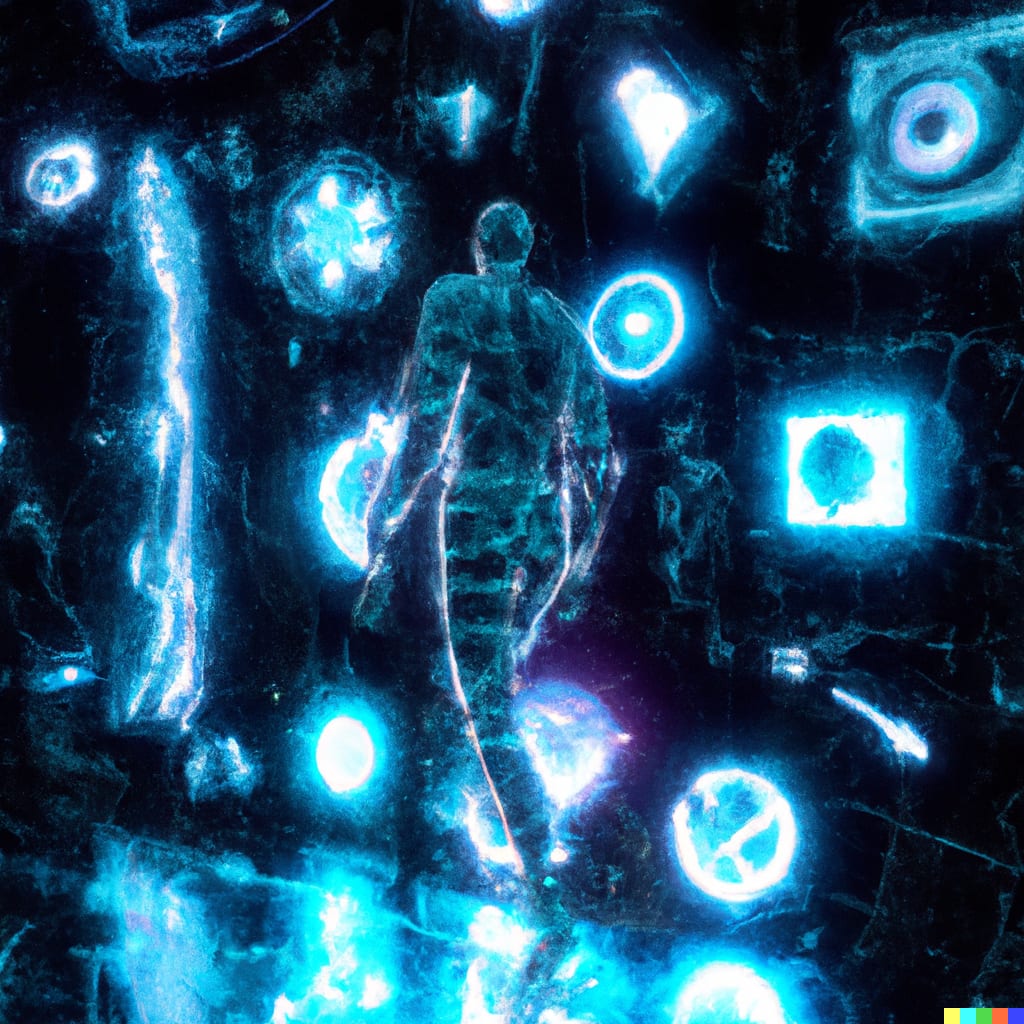
En 2023 publiqué aquí una pequeña galería para presentar la generación de imágenes a compañeros de trabajo. Las imágenes salían de DALL·E 2 a través de la web de OpenAI: sin control sobre el modelo, sin semillas, sin posibilidad de ajuste fino, y cada imagen salía de mi máquina. Era magia, y también una caja negra.
Dónde está ahora: todo en local
El pipeline del clip tiene tres etapas, todas dentro de ComfyUI:
- Imagen: FLUX.1 [dev] en fp8. 12.000 millones de parámetros. En bf16 solo el transformer ocupa ~24 GB, que no deja sitio al codificador de texto T5 en una 3090, así que uso el checkpoint fp8 (~12 GB) con el codificador T5-XXL también en fp8. 20–28 pasos a 1280×720, sampler Euler, guidance 3,5. El aspecto que ves (piel natural, bloom de neón creíble, carteles de estilo japonés coherentes) es lo que convirtió a FLUX en el modelo abierto de imagen más usado.
- Vídeo: Wan2.1 I2V-14B 720p en fp8. El fotograma entra en el nodo
WanImageToVideojunto a un prompt de movimiento breve (“lento acercamiento, lluvia cayendo, gira ligeramente la cabeza”). El modelo de 14B en fp8 más el codificador UMT5-XXL en fp8 caben en 24 GB descargando el codificador de texto a CPU. 49 fotogramas a 16 fps → unos tres segundos de movimiento, recortados después al bucle que ves. - Post: interpolación y codificación. RIFE 2× hasta 24/30 fps y exportación a H.264 y VP9 para la web.
Modelos abiertos de imagen que puedes ejecutar en casa
Mi lista de trabajo de modelos text-to-image de pesos abiertos, ordenable por cualquier columna. El nombre enlaza a la ficha de cada modelo, donde está su licencia y documentación. “VRAM” es una cifra práctica para una sola GPU; con pesos GGUF y offload la mayoría bajan más, a costa de velocidad.
| Stable Diffusion 1.5 | Runway / Stability AI | 2022-10 | ≈0.9B | 4 GB | Huge LoRA / ControlNet ecosystem, very fast |
| SDXL 1.0 | Stability AI | 2023-07 | 3.5B (base) | 8 GB | Mature fine-tunes, good composition |
| Stable Diffusion 3.5 Medium | Stability AI | 2024-10 | 2.5B | 10 GB | Balanced quality on mid-range GPUs |
| Stable Diffusion 3.5 Large | Stability AI | 2024-10 | 8B | 18 GB (bf16) / ~12 GB fp8 | Prompt adherence, typography |
| FLUX.1 [schnell] | Black Forest Labs | 2024-08 | 12B | 24 GB (bf16) / ~12 GB fp8 | 1–4 steps, fully open license |
| FLUX.1 [dev] | Black Forest Labs | 2024-08 | 12B | 24 GB (bf16) / ~12 GB fp8 | Photorealism, most popular open model |
| FLUX.1 Kontext [dev] | Black Forest Labs | 2025-06 | 12B | 24 GB (bf16) / ~12 GB fp8 | Instruction-based image editing |
| FLUX.1 Krea [dev] | Black Forest Labs × Krea | 2025-07 | 12B | 24 GB (bf16) / ~12 GB fp8 | Natural look, avoids the "AI sheen" |
| Qwen-Image | Alibaba Tongyi | 2025-08 | 20B | 20 GB fp8 / ~8 GB GGUF Q4 | Best-in-class text rendering, editing |
| Z-Image-Turbo | Alibaba Tongyi | 2025-11 | 6B | 16 GB | 8 steps, photoreal, bilingual text |
| FLUX.2 [dev] | Black Forest Labs | 2025-11 | 32B | fp8 on 24 GB RTX (with offload) | Generation + multi-reference editing in one model |
| FLUX.2 [klein] 4B | Black Forest Labs | 2026-01 | 4B | ~13 GB | Sub-second generation, fully open |
| FLUX.2 [klein] 9B | Black Forest Labs | 2026-01 | 9B | ~20 GB | Klein quality ceiling, editing |
Última actualización: 2026-09-27. Cada modelo enlaza a su ficha, donde están la licencia y las condiciones de uso.
Cómo elijo. Para trabajo personal, FLUX.1 [dev] y su variante Krea siguen siendo mi opción por defecto para fotorrealismo. Qwen-Image cuando la imagen contiene texto, Z-Image-Turbo o FLUX.2 [klein] 4B cuando necesito iterar mucho y rápido en 16 GB. FLUX.2 [dev] es el techo actual de calidad para edición con varias imágenes de referencia, pero con 32B va muy justo en una 3090.
Modelos abiertos de vídeo
El vídeo es donde la generación local se volvió interesante en 2025. La tabla recoge lo que he ejecutado o evaluado; la columna de VRAM es la cifra de la comunidad para tarjetas de 24 GB con pesos fp8/GGUF y offload, a menudo muy por debajo del requisito “oficial” para una sola GPU.
| Wan2.1 T2V-1.3B | 2025-02 | 1.3B | Text-to-video | 480p | 8 GB | Entry point; fast on any modern GPU |
| Wan2.1 I2V-14B (480p / 720p) | 2025-02 | 14B | Image-to-video | 480p or 720p, 16 fps | 24 GB (fp8 + offload) | The model behind the clip on this page |
| Wan2.2 TI2V-5B | 2025-07 | 5B | Text/Image-to-video | 720p, 24 fps | 24 GB (with offload) | High-compression VAE; fast but softer output |
| Wan2.2 T2V / I2V-A14B (MoE) | 2025-07 | 27B total / 14B active | Text-to-video, Image-to-video | 480p or 720p | 24 GB (fp8/GGUF + offload); official ≥80 GB | Two experts (high-noise / low-noise); best open quality |
| HunyuanVideo 1.5 | 2025-11 | 8.3B | Text-to-video, Image-to-video | 480p–720p, 5–10 s (+1080p super-res) | 14 GB (with offload) | Lightweight; step-distilled variants available |
| LTX-2 | 2026-01 | 19B | Text/Image-to-video with synchronized audio | Multi-scale pipeline with 2× spatial/temporal upscalers | fp8 / nvfp4 checkpoints for consumer GPUs | First open DiT to generate audio + video jointly |
Última actualización: 2026-09-27. Las cifras de VRAM son las que la comunidad consigue en tarjetas de 24 GB con fp8/GGUF y offload en ComfyUI; los requisitos oficiales suelen ser mucho mayores.
¿Por qué Wan2.1 para el clip? Porque a principios de 2025 fue el primer modelo abierto con licencia Apache-2.0, un checkpoint image-to-video de 14B y un workflow de ComfyUI que de verdad cabía en 24 GB. Los modelos MoE de Wan2.2 se ven mejor pero son más lentos en una 3090; HunyuanVideo 1.5 es hoy la opción de calidad más ligera; LTX-2 es el que hay que vigilar porque genera audio y vídeo a la vez.
Lo que aprendí
- Las licencias importan más que los benchmarks. Algunos de los mejores modelos no permiten uso comercial; cada ficha enlazada en las tablas indica las condiciones.
- fp8 lo cambió todo para las tarjetas de 24 GB. Sin él, los transformers de difusión de 12B–14B quedarían fuera del alcance de una 3090.
- Primero la imagen, luego el movimiento. Conseguir un buen fotograma con FLUX y animarlo con I2V da mucho más control que text-to-video, y es más barato de iterar.
- ComfyUI es el sistema operativo de este campo. Cada modelo de la tabla tiene un workflow de ComfyUI a los pocos días de publicarse.
Si quieres el JSON del workflow que genera el clip de esta página, pídemelo por LinkedIn.